Le persone che non conoscono gli array GPR potrebbero pensare che i dati dell'array significhino più o meno la stessa cosa. Sebbene ciò sia in parte vero, ci sono altri dettagli che, se presi in considerazione, possono facilitare le fasi successive di caricamento, elaborazione e interpretazione di tali dati. La presente nota intende fornire alcuni cenni sul processo di raccolta dei dati e sulla successiva gestione dei dati raccolti.

Volume e densità dei dati:
Un piccolo progetto 3D può contenere circa 5 GB di dati grezzi in totale. Non è un file di grandi dimensioni per gli standard moderni e abbastanza facile da trasferire utilizzando una memory stick. Tuttavia, dal punto di vista della sicurezza e dell'elaborazione dei dati, non è saggio mettere tutti quei dati in un unico file. Come mai? Le chiavette di memoria economiche sono soggette a danneggiamento dei file durante il trasferimento e questo può essere particolarmente problematico se i dati si trovano in un unico file e sono interessati in qualsiasi modo non immediatamente percepibili dall'operatore.
Di conseguenza, consigliamo di dividere anche i piccoli progetti in più andane parallele (se possibile). Inoltre, il volume dei dati è lineare rispetto alla distanza del punto, dove metà della distanza del punto significa il doppio del volume dei dati. Di solito non è di alcun vantaggio raccogliere dati con una densità maggiore della metà della spaziatura del canale dell'array. Pertanto, una matrice con una spaziatura dei canali di 8 cm equivale a una distanza tra i punti di 4 cm.
Navigazione (nei dati):
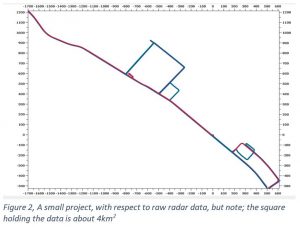
La figura 2 sopra mostra un progetto piuttosto piccolo, per quanto riguarda i dati radar grezzi (circa 4.5 GB), ma l'interpretazione di un progetto come questo significa navigare da una scala di km fino a pochi metri, il che mette abbastanza elevata richiesta del software di elaborazione in uso.
 Posizionamento:
Il posizionamento è, di gran lunga, uno dei maggiori punti di discussione sulla raccolta di dati di array. L'uso di RTK-GPS ad alta precisione è il metodo di posizionamento più conveniente ed efficiente e, per questi motivi, prevale sull'uso delle stazioni totali. Tuttavia, questa comodità diventa inefficace nelle aree in cui il segnale è interrotto, ad esempio da alberi, edifici alti o altri ostacoli sopraelevati. In definitiva, è l'ambiente di rilevamento stesso che determina il metodo di posizionamento da utilizzare. Per le descrizioni che seguono, è importante notare che solo RTK-fix è sufficiente e che qualsiasi perdita di RTK-fix causerà lavoro extra nella gestione dei dati.
A volte è possibile salvare un progetto con un posizionamento scadente; tuttavia, se il progetto è di grandi dimensioni con un'elevata percentuale di errori di posizionamento, potrebbe essere più economico eseguire nuovamente il sondaggio con un posizionamento migliore piuttosto che perdere tempo prezioso nel tentativo di risolverlo. Un'altra considerazione importante che potrebbe facilitare l'elaborazione in seguito è la scelta della densità di posizionamento durante la raccolta dei dati, poiché una densità troppo elevata può causare lavoro extra. Se non si dispone di un controllo adeguato sul processo di posizionamento, non ha molto senso schierarsi sul campo per la raccolta dei dati.
Curve brusche durante la raccolta dei dati:
Quando si raccolgono dati sul campo, è perfettamente fattibile spostare l'array in modo da produrre una curva, o raggio, lungo l'andana raccolta. Tuttavia, è bene pensare a cosa farà questo tipo di manovra alla successiva gestione dei dati. Come illustrato nella Figura 3, un tale raggio si traduce in dati che sono significativamente allungati lungo il perimetro esterno, mentre vengono compressi lungo il perimetro interno. Il modo in cui ciò può influire sull'immagine finale dipende da come sono stati raccolti i dati. Ad esempio, se la distanza del punto è impostata su 4 cm durante la raccolta dei dati e 8 cm durante l'interpolazione, potrebbe funzionare, ma l'interpolazione alla stessa dimensione del contenitore della distanza del punto avrà un impatto definitivo sui dati. Pertanto, è importante considerare tali fattori quando si pianifica un'indagine; se tali svolte sono inevitabili, strutturare l'indagine in modo che i dati raccolti in questi punti non siano i più importanti per l'indagine complessiva.
Buchi nei dati
Cosa succede con le aree non coperte dai dati radar? Bene, il software moderno offre una certa capacità di interpolare i dati in tali spazi vuoti, ma a volte applicare la regolarizzazione può essere una scelta migliore. Indipendentemente dalla funzione teorica impiegata, se gli spazi vuoti sono troppo grandi, nessun software può risolverlo e quelle aree saranno inutili per l'interpretazione. Un altro problema meno ovvio è che la funzione di interpolazione/binning occupa spazio di memoria sul computer di elaborazione, ma in che misura dipende dal software di elaborazione scelto. Un progetto come quello mostrato nella Figura 4 può essere difficile da elaborare a causa delle aree molto grandi, non riempite e chiuse. Naturalmente, se si sceglie di elaborare definendo manualmente le aree da interpolare ("chunking"), potrebbe sempre essere possibile, ma è piuttosto vecchio stile.
La Figura 5 mostra un progetto con 4.5 GB di dati radar grezzi, gli stessi del progetto mostrato sopra nella Figura 2. Tuttavia, il layout di questo progetto è molto migliore per quanto riguarda la gestione dei dati, perché è facile da navigare, non ha curve strette, né buchi nei dati.

Takeaway
Anche con la migliore pianificazione, un progetto reale potrebbe contenere dati non ottimali. Pertanto, quando si ha a che fare con i volumi di dati da un moderno sistema GPR-array, è sempre consigliabile eliminare i dati problematici il prima possibile. La prossima nota di questa serie tratterà il tema del QA/QC dei dati e discuterà gli strumenti utili per la selezione e la gestione delle importazioni di dati.